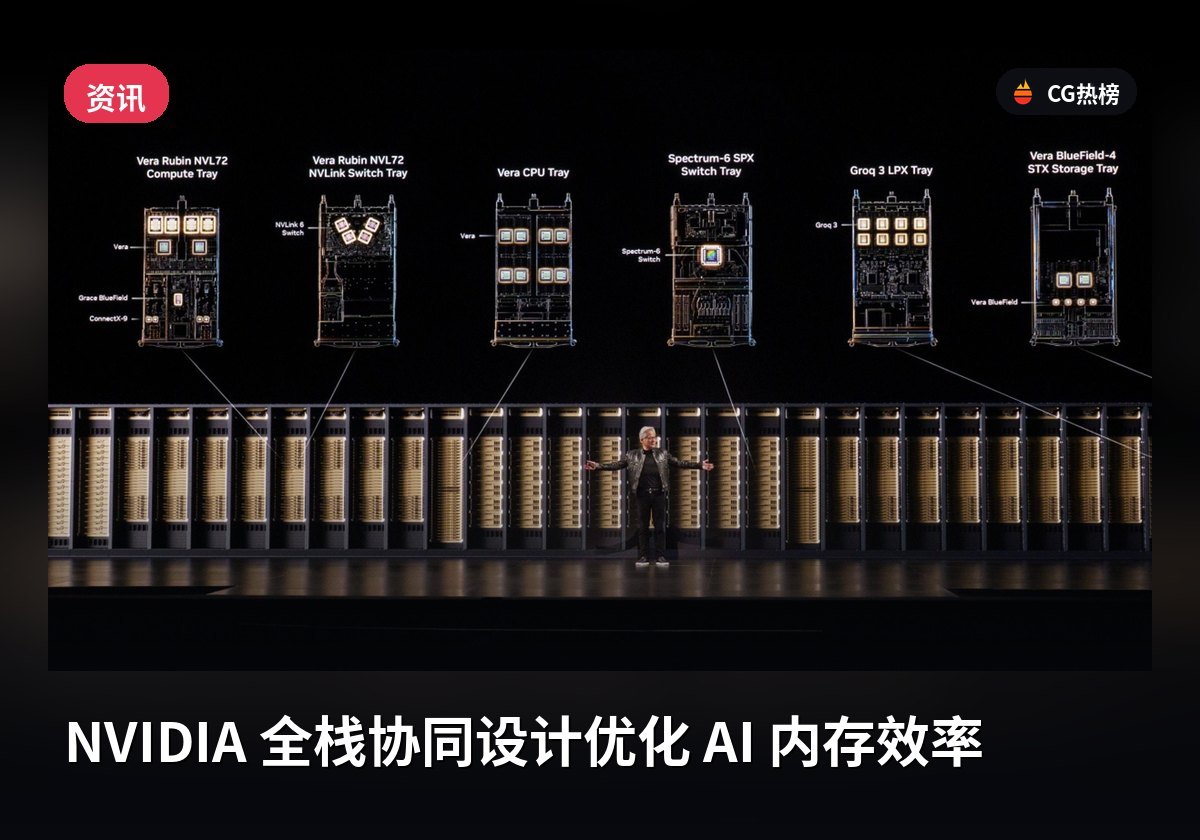
NVIDIA 针对大模型推理中的内存瓶颈,提出全栈协同设计方案。通过 NVFP4 精度压缩模型权重与 KV 缓存,结合 NVL72 架构将权重分布在多 GPU 上,释放 HBM 空间。同时利用 Vera CPU 的大容量 LPDDR 内存及 CMX 存储层,实现非活跃上下文的高效卸载与复用。该方案旨在突破“内存墙”限制,在 HBM 容量仅微增的情况下,显著提升智能体推理的每美元吞吐量,优化 AI 工厂的整体资源利用率。
要点
- 采用 NVFP4 格式压缩模型权重和 KV 缓存,相比 FP8 显著降低内存占用。
- 在 NVL72 系统中将模型权重分布在 72 个 GPU 上,为 KV 缓存腾出更多 HBM 空间。
- 利用 Vera CPU 的 LPDDR 内存和 NVLink-C2C 互连,快速暂存非活跃上下文。
- 引入 NVIDIA CMX 上下文内存存储层,以更低成本处理长周期上下文数据。
- Dynamo 软件统一管理跨 GPU、CPU 和存储的 KV 缓存,实现系统级资源复用。
为什么值得关注
对于国内 AI 从业者,该方案展示了在硬件受限下通过软件与架构协同提升推理效率的路径。NVFP4 精度和分层存储策略可为构建低成本、高吞吐的生成式 AI 应用提供参考,尤其适用于需要处理长上下文和复杂智能体任务的场景。
本文由 CG热榜基于公开资料重新撰写,以原始资料为准。来源:NVIDIA Blog
© 版权声明
本文由 CG热榜基于公开资料重新撰写,原始资料版权归原作者,来源见文末。