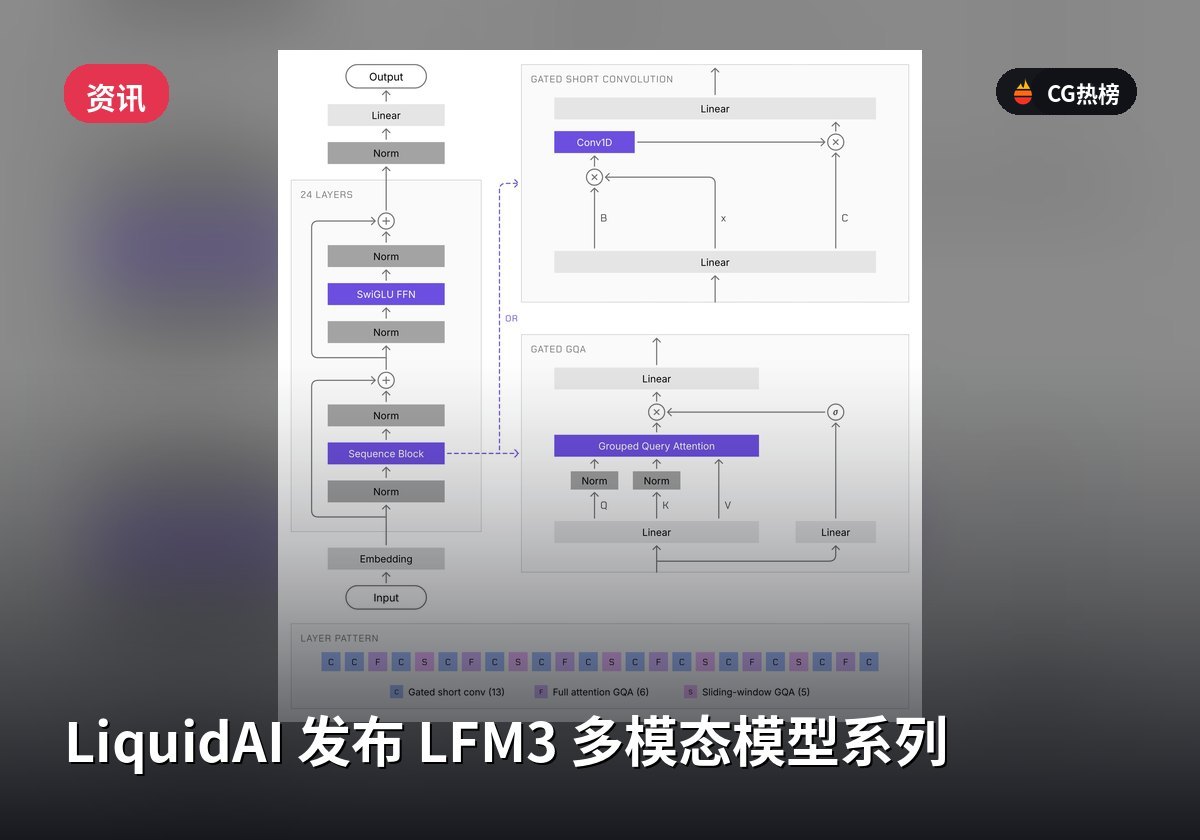
LiquidAI 推出新一代 LFM3 基础模型,基于 1.7B 参数骨干统一支持文本、视觉、音频及决策任务。该系列采用三混合架构,在减少 35% 参数的情况下性能超越前代 LFM2.5。LFM3 专为边缘设备优化,4-bit 精度下仅占约 1GB 内存,支持 256K 上下文窗口。用户可在单 GPU 上对特定模态模型进行微调,适用于端侧智能体部署,显著降低多模态应用的算力门槛。
要点
- LFM3 系列包含六个 2B 级模型,覆盖文本、视觉、音频、全模态及决策场景,均源自同一 1.7B 基础骨干。
- 引入三混合层架构,结合门控短卷积、滑动窗口注意力与全局注意力,提升长上下文推理效率。
- 视觉编码器计算量比 SigLIP2 减少 3 倍,音频模型集成 LiquidCodec,支持语音输出。
- 文本模型在 4-bit 量化下体积约 1GB,支持 256K 上下文,适合手机、Raspberry Pi 等端侧设备运行。
- 所有模型均支持单 GPU 微调,便于开发者针对特定领域数据定制专用智能体。
为什么值得关注
LFM3 提供了低成本的多模态端侧部署方案,其单 GPU 微调特性降低了国内开发者构建垂直领域 AI 应用的门槛。对于游戏美术或影视特效从业者,可利用其视觉模型进行本地化素材分析或自动化流程辅助,无需依赖云端高算力资源。
本文由 CG热榜基于公开资料重新撰写,以原始资料为准。来源:Hugging Face
© 版权声明
本文由 CG热榜基于公开资料重新撰写,原始资料版权归原作者,来源见文末。